مدیریت، نگهداری و پایش زیرساخت شبکه (Infrastructure Monitoring & Observability)
۳ آبان ۱۴۰۵
۱ مقدمه و فلسفه پایش و نگهداری زیرساخت
پایش، نگهداری و مدیریت زیرساخت (Infrastructure Monitoring & Maintenance)، شریان حیاتی پایداری خدمات فناوری اطلاعات و ستون فقرات مراکز داده و شبکههای سازمانی است. با گسترش پیچیدگی بارهای کاری و توزیعشدگی سامانهها، رویکردهای سنتی که صرفاً مبتنی بر واکنش پس از وقوع خرابی (Reactive Approach) بودند، کارایی خود را از دست دادهاند و جای خود را به مهندسی پیشگیرانه و مشاهدهپذیری فراگیر (Observability) دادهاند.
در این پارادایم، سامانه پایش نه تنها وضعیت در دسترس بودن تجهیزات فیزیکی و منطقی را رصد میکند، بلکه با تحلیل پیوسته سنجهها (Metrics)، رویدادها (Logs) و ردگیریها (Traces)، امکان پیشبینی گلوگاهها، شناسایی زودهنگام ناهنجاریها و برآوردهسازی دقیق توافقنامههای سطح خدمت (SLA) را فراهم میآورد. مدیریت زیرساخت چرخه کاملی از طراحی ظرفیت، پیکربندی هماهنگ، نگهداری دورهای و بازسازی بلادرنگ را در بر میگیرد تا کمترین میزان وقفه در سرویسدهی پدید آید.
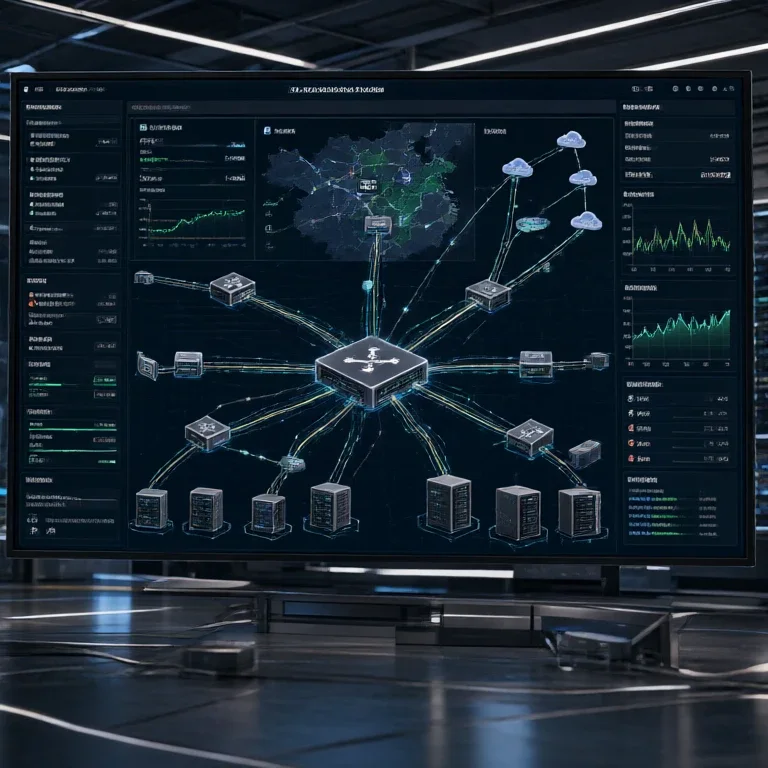
مرکز عملیات شبکه و داشبورد مانیتورینگ زیرساخت
۲ معماری و لایههای پایش (از جمعآوری تا داشبورد)
یک اکوسیستم مدرن مانیتورینگ از چهار لایه اصلی تشکیل شده است که پیوسته در تعامل با یکدیگر دادههای خام زیرساخت را به اطلاعات تحلیلی و تصمیمساز تبدیل میکنند:
[تجهیزات زیرساخت: سوئیچ، روتر، سرور، کانتینر] │ ▼ (پروتکلهای جمعآوری: SNMP, Telemetry, Agents, Flow) [لایه تجمیع و انتقال (Collectors & Ingestion: Telegraf, Vector, Logstash)] │ ▼ (خط لوله انتقال پیام: Kafka / RabbitMQ) [لایه ذخیرهسازی دادههای سری زمانی و لاگ (TSDB & Log Storage: InfluxDB, Prometheus, OpenSearch)] │ ▼ (پردازش، مصورسازی و تصمیمگیری) [موتورهای هشداردهی (Alertmanager) و داشبوردهای تحلیلی (Grafana, Kibana)]
۲.۱ ۱. لایه جمعآوری و سنسورها (Data Collection Layer)
این لایه شامل عاملهای نرمافزاری (Agents نظیر Node Exporter و Telegraf) و سازوکارهای بدون عامل (Agentless نظیر پرسوجوی SNMP یا دریافت جریانهای تلمتری) است که وظیفه استخراج آمارهای بلادرنگ سیستمعامل، وضعیت پورتها، دمای سختافزار و ترافیک پردازنده را بر عهده دارند.
۲.۲ ۲. لایه تجمیع، پایپلاین و ذخیرهسازی سری زمانی (Storage & TSDB)
دادههای متریک به دلیل نرخ تولید بالا و نیاز به تفکیک زمانی، در پایگاههای داده سری زمانی (Time-Series Databases) نظیر Prometheus، InfluxDB یا VictoriaMetrics ذخیره میشوند. دادههای ساختارنیافته مانند لاگهای Syslog نیز به خوشههای مبتنی بر Lucene نظیر Elasticsearch یا OpenSearch هدایت میگردند.
۲.۳ ۳. لایه بصریسازی و مشاهدهپذیری (Visualization & Observability)
سامانههایی چون Grafana دید یکپارچهای از کل زیرساخت از طریق ترسیم نمودارهای ترافیک، بار محاسباتی و وضعیت ارتباطات فراهم میآورند که امکان ریشهیابی سریع رخدادها را به مدیران شبکه میدهد.
۳ پروتکلهای استاندارد و مکانیسمهای جمعآوری داده
فرایند گردآوری دادهها در زیرساخت شبکه وابسته به پروتکلهای متعددی است که بر اساس نوع داده و حساسیت زمانی انتخاب میشوند:
| پروتکل / استاندارد | مدل تعاملی | لایه و فرمت انتقال | کاربرد اصلی | مزایا و معایب |
| SNMP (v2c / v3) | Pull (Polling) و Push (Traps) | UDP (161/162) - کدگذاری ASN.1 BER | خواندن آمارهای عمومی تجهیزات و اینترفیسها | همهگیر در تجهیزات سنتی؛ سربار بالای پردازشی و تاخیر بالا در Polling دورهای |
| IPFIX / NetFlow | Push (Flow-based) | UDP/SCTP (RFC 7011) - فرمت باینری الگومحور | تحلیل دقیق جریانهای ترافیکی (سورس، مقصد، پورت، پروتکل) | مناسب رصد ترافیک و صورتحساب؛ عدم ارائه مستقیم سلامت سختافزاری |
| gNMI (OpenConfig) | Push (Streaming Telemetry) | gRPC روی HTTP/2 (RFC / Spec OpenConfig) - باینری Protobuf | مانیتورینگ بلادرنگ با فرکانس بسیار بالا بر مبنای مدلهای YANG | مصرف بهینه پهنای باند و CPU، دریافت تغییرات به صورت On-Change ؛ نیازمند پشتیبانی تجهیزات جدید |
| Syslog (RFC 5424) | Push (Event-driven) | UDP/TCP/TLS (پورت ۵۱۴) | ثبت رویدادهای سیستم، هشدارهای امنیتی و رخدادهای کریتیکال | استانداردی همگانی؛ نیازمند نرمالسازی لاگها به دلیل تنوع فرمت سازندگان |
پروتکل IPFIX (RFC 7011) به عنوان استاندارد جهانی صادرات اطلاعات جریان ترافیک، به مدیران امکان میدهد با پایش بستهها در سطح سوئیچ و روتر، مصرف پهنای باند و جریانهای غیرمجاز را به سرعت ردگیری کنند. از سوی دیگر، پروتکل مدرن gNMI بر بستر gRPC تحولی بنیادین در جایگزینی روشهای کند Polling ایجاد کرده و با فراهمسازی اشتراکهای جریانی (Stream Subscriptions) و دریافت اعلانات اتمیک، وضعیت سنسورها را با دقت میکروثانیهای گزارش میدهد.
۴ مدیریت خطا، هشداردهی (Alerting) و اتوماسیون پاسخ
کارایی یک سامانه پایش در نحوه برخورد آن با خطاها و تفکیک سیگنال واقعی از نویزهای هشداردهی (Alert Fatigue) سنجیده میشود:
۴.۱ ۱. آستانهگذاری پویا و چندسطحی
تعریف آستانهها به صورت استاتیک (مانند هشدار در عبور مصرف CPU از ۸۰ درصد) اغلب منجر به هشدارهای کاذب در زمان بارگذاریهای مقطعی میشود. بهکارگیری آستانهگذاری چندسطحی شامل اخطار (Warning)، بحرانی (Critical) و بهرهگیری از میانگینهای متحرک یا الگوریتمهای هوش مصنوعی (AIOps) رفتارهای نرمال را از رخدادهای غیرعادی تفکیک میکند.
۴.۲ ۲. همبستهسازی رویدادها (Event Correlation)
هنگامی که یک سوئیچ Core دچار قطعی میشود، صدها سرور و تجهیز متصل به آن هشدارهای عدم دسترسی ارسال میکنند. سامانههای مدرن با درک توپولوژی شبکه، هشدارهای فرعی را تجمیع کرده و تنها یک رویداد ریشهای (Root Cause Analysis) تولید مینمایند.
۴.۳ ۳. اتوماسیون پاسخ و خودترمیمی (Automated Remediation)
اتصال پایپلاین هشدار به ابزارهای اتوماسیون شبکه نظیر Ansible یا وبهوکهای سفارشی به تیمهای عملیات امکان میدهد خطاهای پرتکرار (مانند پر شدن بافر لاگها، از دست رفتن مسیر BGP یا خرابی یک پردازه نرمافزاری) را بدون دخالت انسانی و از طریق اجرای اسکریپتهای اصلاحی بازسازی کنند.
۵ شاخصهای کلیدی عملکرد (KPIs) و ارزیابی سلامت زیرساخت
برای حصول اطمینان از سلامت پایدار زیرساخت، رصد مستمر مجموعهای از شاخصهای کلیدی عملکرد الزامی است:
نرخ در دسترس بودن (Availability & Uptime): پایش درصد زمان عملیاتی بودن سرویس و تجهیز مطابق با سطح توافقشده (مثلاً ۹۹٫۹۹٪).
تاخیر انتقال (Latency / RTT): مدتزمان رفت و برگشت بستهها در مسیرهای بحرانی؛ افزایش نامتعارف تاخیر نشاندهنده اشباع بافرها یا تغییرات مسیر نامطلوب است.
نوسان تاخیر (Jitter): متغیر بودن تاخیر در انتقال بستهها که کیفیت سرویسهای حساس به زمان نظیر VoIP و کنفرانسهای تصویری را به شدت تحت تاثیر قرار میدهد.
نرخ اتلاف بسته (Packet Loss): درصدی از ترافیک ارسالی که به مقصد نمیرسد؛ افت حتی ۱٪ بسته میتواند توان عملیاتی نشستهای TCP را به دلیل مکانیزمهای کنترل ازدحام به شدت کاهش دهد.
معیارهای سختافزاری (Hardware Metrics): دمای شاسی و تجهیزات، سلامت منابع تغذیه موازی (Redundant PSUs)، دور فنهای خنککننده، بار پردازشی CPU و میزان اشغال حافظه اصلی و بافرهای سوئیچ.
معیارهای محیطی دیتا سنتر (Environmental Metrics): مانیتورینگ درجه حرارت راهروهای گرم و سرد (Cold/Hot Aisle)، رطوبت نسبی و وضعیت سامانههای تغذیه بدون وقفه (UPS) و دیزلژنراتورها.
۶ بهترین روشهای مهندسی و الگوهای عملیاتی (Best Practices)
حفظ پایدار زیرساخت نیازمند رعایت اصول مدون در نگهداری پیشگیرانه است:
حذف نقاط منفرد شکست (SPOF): استقرار سرورها و پایگاههای داده مانیتورینگ در قالب کلاستر افزونه و نظارت بر خود سامانه پایش با ناظر خارجی (Watchdog).
شبکه پایش خارج از باند (OOB): هدایت ترافیک نظارتی و تلمتری در شبکه یا VLAN کاملاً ایزوله تا در زمان وقوع ازدحام داده، نظارت بر خطوط قطع نگردد.
نگهداری پیشگیرانه فیزیکی: بازبینی دورهای توان لیزر ماژولهای نوری (DOM)، سلامت باتریهای UPS، فنها و بهروزرسانی سیستمعامل تجهیزات.
پشتیبانگیری خودکار پیکربندی: ذخیرهسازی خودکار و نسخهبندیشده کانفیگ تجهیزات اکتیو برای بازیابی سریع در شرایط بحران (Disaster Recovery).
ممیزی دورهای هشدارها: بازنگری فصلی قواعد مانیتورینگ جهت پالایش هشدارهای غیرضروری و بهروزرسانی چرخههای کشیک عملیاتی (On-Call).